Aggiornato settembre 2026
Storia dell’intelligenza artificiale
La storia dell’intelligenza artificiale si legge male come una linea che sale. Si legge meglio come una successione di ondate: un’idea tecnica mostra un risultato inatteso, le aspettative crescono oltre ciò che l’idea può reggere, i finanziamenti si ritirano, e vent’anni dopo la stessa idea torna con più dati e più calcolo. È successo due volte in modo abbastanza netto da meritare un nome, «inverno dell’IA», e sta succedendo una terza volta con esiti che non sono ancora storia.
Il neurone formale, 1943
Nel 1943 il neurofisiologo Warren McCulloch e il logico Walter Pitts pubblicano un modello matematico del neurone: un’unità che somma ingressi pesati e si attiva superata una soglia. Il loro risultato è che reti di unità così definite possono calcolare qualunque funzione logica. È il primo ponte fra la biologia del sistema nervoso e la teoria del calcolo[1].
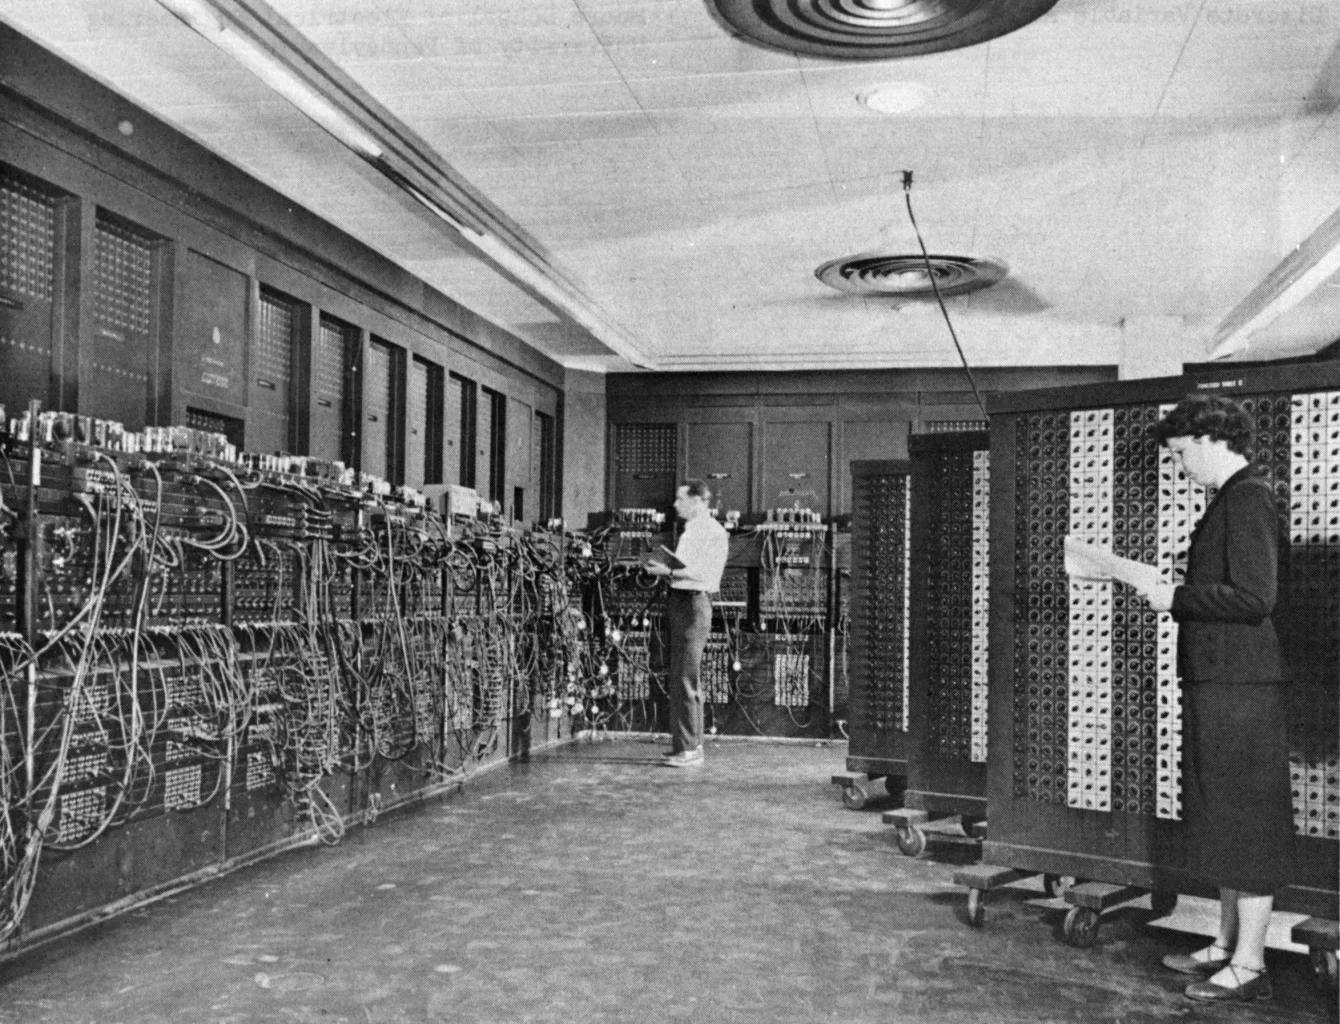
Il contesto tecnico è quello delle prime macchine elettroniche a programma. L’ENIAC, completato nel 1945, non ha nulla a che vedere con l’intelligenza artificiale: stabilisce però la condizione materiale senza la quale il campo non esisterebbe, cioè la possibilità di eseguire un gran numero di operazioni aritmetiche in tempi utili.
La domanda di Turing, 1950
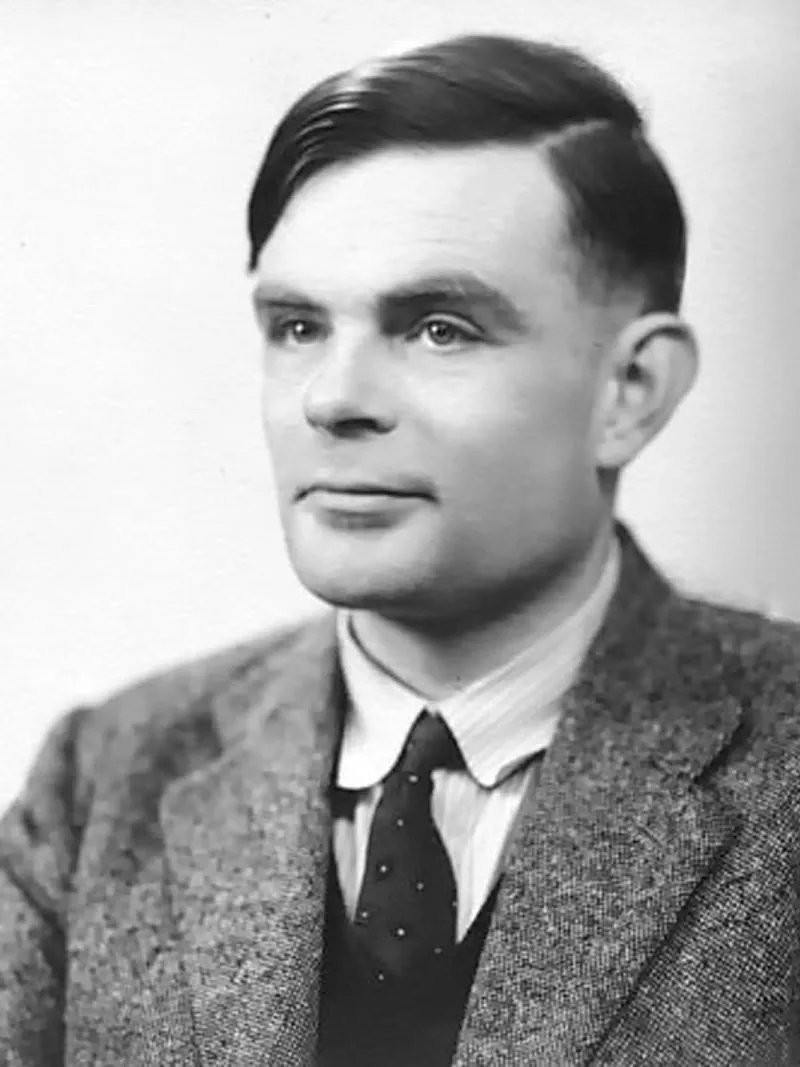
Nel 1950 Alan Turing pubblica su Mind l’articolo «Computing Machinery and Intelligence». La mossa decisiva non è una risposta ma una sostituzione: alla domanda «le macchine possono pensare?», che giudica troppo indeterminata per essere discussa, sostituisce una prova operativa, il gioco dell’imitazione[2].
Un valutatore conversa per iscritto con due interlocutori nascosti, una persona e una macchina, e deve stabilire quale sia quale. Se non ci riesce meglio del caso, la domanda di partenza perde interesse. L’articolo contiene anche la risposta alle obiezioni prevedibili e l’idea di una macchina che apprende invece di essere programmata.
Il nome, 1956
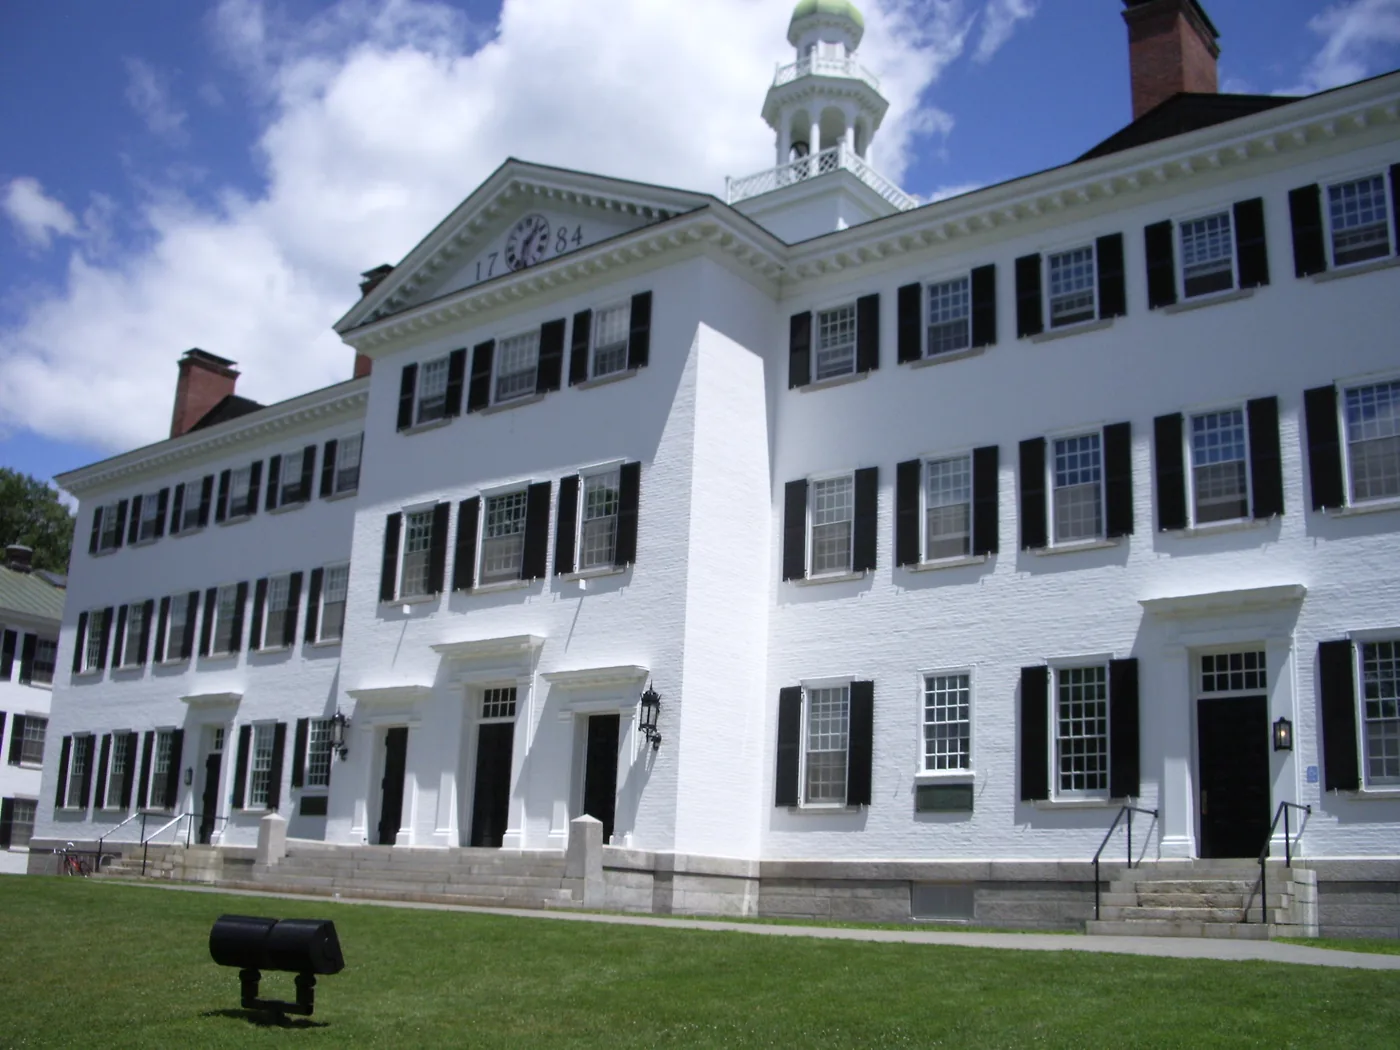
Nell’estate del 1956 un seminario di due mesi al Dartmouth College riunisce John McCarthy, Marvin Minsky, Nathaniel Rochester e Claude Shannon con una decina di altri partecipanti. La proposta di finanziamento, scritta l’anno prima, contiene l’espressione «artificial intelligence» e la congettura che ogni aspetto dell’apprendimento possa essere descritto con precisione sufficiente a farlo simulare da una macchina[3].
Il seminario non produce risultati tecnici. Produce un nome, una comunità e un’agenda che tiene per vent’anni: dimostrazione automatica di teoremi, giochi, linguaggio, reti neurali, astrazione.
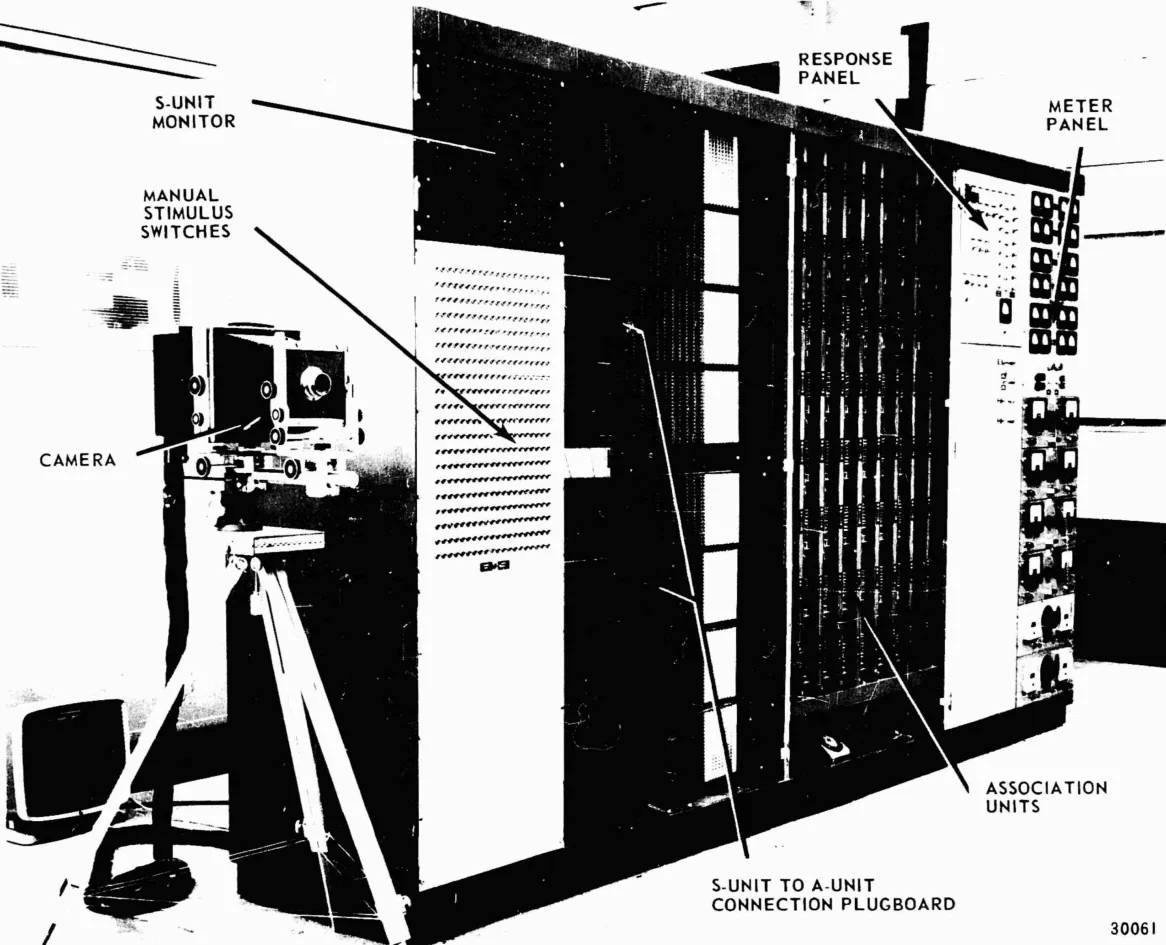
Due anni dopo Frank Rosenblatt pubblica il percettrone, un modello di apprendimento supervisionato che aggiorna i pesi in base all’errore commesso. Il Mark I Perceptron ne è la realizzazione fisica: una macchina con una matrice di fotocellule e potenziometri motorizzati[4].
I due inverni
Nel 1969 Marvin Minsky e Seymour Papert dimostrano che un percettrone a strato singolo non può calcolare funzioni non linearmente separabili. La dimostrazione è corretta e limitata a quel caso; l’effetto sulla ricerca è molto più ampio del suo contenuto, e i finanziamenti alle reti neurali si contraggono per un decennio[5].
Il primo inverno vero e proprio si colloca fra il 1974 e il 1980. Rapporti commissionati da enti pubblici britannici e statunitensi giudicano i risultati sproporzionati rispetto alle promesse, in particolare sulla traduzione automatica e sul ragionamento generale. I programmi vengono ridimensionati.
Il secondo arriva fra il 1987 e il 1993 e ha una causa più industriale che scientifica: il mercato delle macchine dedicate al linguaggio Lisp crolla di fronte a calcolatori generalisti più economici, e con esso l’industria dei sistemi esperti che vi si appoggiava.
I sistemi esperti e la svolta statistica
Fra il 1980 e il 1987 i sistemi esperti sono la forma industriale dell’intelligenza artificiale: una base di regole scritte da specialisti e un motore di inferenza che le applica a un caso. Funzionano dove il dominio è ristretto e le regole sono esplicitabili — configurazione di calcolatori, diagnosi in specialità circoscritte — e falliscono dove la conoscenza è tacita o il dominio è aperto. Il costo di manutenzione delle basi di regole si rivela il limite decisivo[6].
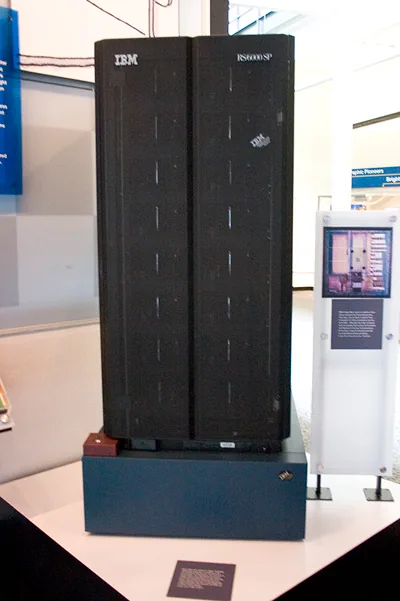
Negli anni Novanta il campo si riorienta verso metodi statistici e probabilistici, e verso problemi misurabili su insiemi di prova condivisi. Nel maggio 1997 Deep Blue batte il campione del mondo di scacchi in carica su sei partite[7]. La macchina non apprende: esplora l’albero delle mosse con una funzione di valutazione costruita a mano e hardware dedicato. È una vittoria della potenza di calcolo, e viene letta come una vittoria dell’intelligenza artificiale.
L’apprendimento profondo, 2012
Nel 2012 una rete convoluzionale addestrata su schede grafiche vince la competizione ImageNet con un errore nettamente inferiore a quello dei metodi concorrenti[8]. Nessuno degli ingredienti è nuovo: le reti convoluzionali sono degli anni Ottanta, la retropropagazione pure. Sono nuovi la dimensione dell’insieme di addestramento e la disponibilità di hardware parallelo a basso costo.
Il decennio successivo estende il metodo al riconoscimento del parlato, alla traduzione e al gioco. Nel 2016 AlphaGo batte un campione di go, un gioco in cui la ricerca esaustiva non è praticabile[9]. Nel 2018 il premio Turing viene assegnato a Yoshua Bengio, Geoffrey Hinton e Yann LeCun per il lavoro sulle reti profonde[12].
Trasformatori e modelli fondazionali
Nel 2017 un gruppo di ricerca introduce il trasformatore, un’architettura che abbandona la ricorrenza e mette in relazione tutti gli elementi della sequenza in parallelo attraverso il meccanismo di attenzione[10]. La conseguenza pratica è la possibilità di addestrare su quantità di testo prima fuori portata.
Dal 2018 in poi la ricerca segue una regolarità empirica: aumentando parametri, dati e calcolo, le prestazioni migliorano in modo prevedibile. Dal 2022 i modelli così ottenuti diventano prodotti di massa, e il campo si sposta dai laboratori al mercato. L’edizione 2026 dell’AI Index misura la velocità di quello spostamento: il costo dell’inferenza su modelli di una classe di riferimento è sceso di circa 280 volte dalla fine del 2022, e gli investimenti aziendali globali hanno raggiunto 581,7 miliardi di dollari nel 2025[11].
Nello stesso periodo la materia entra nel diritto. Il regolamento europeo del 2024 è la prima disciplina generale di un ordinamento maggiore, e la sua applicazione per gradi è in corso. La parte di storia che comincia qui non ha ancora una forma stabile, e questa voce la registra soltanto per date verificate.
Cronologia sintetica
- 1943 McCulloch e Pitts descrivono il neurone formale: una unità logica a soglia, il primo modello matematico di calcolo neurale.
- 1950 Turing pubblica «Computing Machinery and Intelligence» e propone il gioco dell’imitazione al posto della domanda «le macchine possono pensare?».
- 1956 Il seminario estivo di Dartmouth fissa il nome «artificial intelligence» e riunisce per due mesi i fondatori del campo.
- 1958 Rosenblatt pubblica il percettrone; il Mark I Perceptron ne è la realizzazione in hardware.
- 1969 Minsky e Papert dimostrano i limiti del percettrone a strato singolo. Nello stesso anno si tiene la prima IJCAI.
- 1974–1980 Primo inverno: i finanziamenti si ritirano dopo rapporti critici sui risultati promessi.
- 1980–1987 I sistemi esperti entrano nelle imprese; nasce un’industria di macchine e linguaggi dedicati.
- 1987–1993 Secondo inverno: il mercato delle macchine dedicate crolla e i programmi di ricerca vengono ridimensionati.
- 1997 Deep Blue batte il campione del mondo di scacchi in carica su sei partite.
- 2012 AlexNet vince la competizione ImageNet con un margine tale da riorientare il campo verso le reti profonde su GPU.
- 2016 AlphaGo batte un campione di go, gioco per cui la ricerca esaustiva non è praticabile.
- 2017 Vaswani e altri introducono il trasformatore e il meccanismo di attenzione.
- 2022–2026 I modelli fondazionali diventano prodotti di massa; la regolazione europea entra in vigore e comincia ad applicarsi per gradi.
Fonti
- Wikipedia (en), voce «History of artificial intelligence»
- Alan M. Turing, «Computing Machinery and Intelligence», Mind, LIX (236), 1950
- Wikipedia (en), voce «Dartmouth workshop»
- Wikipedia (en), voce «Perceptron»
- Wikipedia (en), voce «AI winter»
- Wikipedia (en), voce «Expert system»
- Wikipedia (en), voce «Deep Blue (chess computer)»
- Wikipedia (en), voce «AlexNet»
- Wikipedia (en), voce «AlphaGo»
- Ashish Vaswani et al., «Attention Is All You Need», arXiv:1706.03762, 2017
- Stanford HAI, «The 2026 AI Index Report»
- Wikipedia (en), voce «Turing Award»